
Risultato finale: puoi costruire uno strumento di simulazione robusto utilizzando il Fast Excel Development Template senza alcun codice; in questo articolo spiego come e condivido un esempio di simulazione della copertura dell’inventario.
La simulazione nella supply chain e nella pianificazione consente alle aziende di modellare, analizzare e ottimizzare i processi, aiutando a prevedere i risultati, gestire le incertezze e migliorare il processo decisionale per l’inventario, la produzione e la logistica.
Recentemente, il mio eccellente collega su Production-scheduling.com e buon amico Kien Leong ha condiviso come l’integrazione di Python con Excel possa liberare una serie di applicazioni interessanti, compresa una simulazione avanzata dell’inventario. Ti invito calorosamente a visitare il contenuto che ha preparato per te, ne vale davvero la pena. Naturalmente, l’uso di Python, che offre librerie gratuite e open source per quasi tutte le applicazioni informatiche, amplia l’orizzonte di ciò che puoi fare, a costo di padroneggiare un po’ di codice Python.
Ma possiamo fare qualche simulazione utile con il Fast Excel Development Template? Il nostro Fast Excel Development Template offre un sistema di automazione senza codice basato su Excel, presumibilmente il tuo strumento quotidiano per l’elaborazione dei dati.
Infatti, se sei un membro della nostra comunità, sai come beneficiare degli strumenti di codifica automatizzati offerti dal Fast Excel Development Template e costruire un sistema senza codice scritto da esseri umani. Inoltre, distribuire gli strumenti che crei è molto facile: condividi i fogli di lavoro.

Esploriamo insieme come fare simulazioni con il Fast Excel Development Template, senza scrivere alcun codice.
In questo articolo ti insegno come costruire uno strumento di simulazione di inventario semplice con il Fast Excel Development Template (scarica il template qui); inoltre, come sono abituato a fare, puoi scaricare lo strumento di cui parlo nell’articolo disponibile gratuitamente:
Inventory Simulation in Excel Download
Immaginiamo un semplice dispositivo elettronico come quello mostrato qui sotto insieme ad alcuni dei suoi componenti. È composto dall’assemblaggio di componenti di una distinta base con un unico livello. L’officina assembla 5 modelli utilizzando componenti acquistati con tempi di consegna diversi.

Certo, la quantità di domanda giornaliera di ogni prodotto finito è variabile così come il tempo di consegna dei componenti: la generazione di queste due cifre è una parte cruciale del nostro flusso di lavoro di simulazione.
Vogliamo simulare una politica di rifornimento min-max sia per i prodotti finiti che per i componenti. In altre parole, quando il livello di inventario proiettato simulato scende sotto i giorni minimi di copertura, viene emesso un ordine di rifornimento per raggiungere i giorni massimi di copertura tenendo conto del livello di inventario attuale, degli ordini già effettuati ma non ancora consegnati, della quantità minima d’ordine e della massima copertura desiderata.
E per fare questo, vogliamo simulare la domanda dei prodotti finiti e la variazione dei tempi di consegna dei componenti. Utilizzeremo la storia della domanda e la storia dei tempi di consegna per costruire generatori pseudo-casuali di domanda e tempi di consegna. Spiego di seguito il significato della pseudo-casualità.
L’esempio di utilizzo
Questo simulatore è ispirato a un caso reale che ho affrontato riguardo a politiche di copertura dell’inventario migliorabili.
Eseguiamo la simulazione per un anno e la ripetiamo 10 volte.
Nel nostro caso semplice, iniziamo con parametri di copertura min-max rispettivamente di 14 e 21 giorni di calendario per i prodotti finiti e di 7 e 14 per i componenti.
La linea di assemblaggio, che produce i prodotti finiti, è molto flessibile: consideriamo un lead time di un solo giorno. Dall’altra parte, alcuni dei componenti hanno un lungo lead time – fino a 42 giorni – con variabilità.
Eseguendo una simulazione, 10 iterazioni sono sufficienti e dimostrano che queste impostazioni non funzionano: stanno generando un livello di inventario elevato e inutile per i prodotti finiti nella speranza di servire meglio la domanda dei clienti e molto frequenti carenze di componenti non solo a causa della variazione del tempo di consegna ma anche e soprattutto a causa della copertura totale molto bassa rispetto al tempo di consegna nominale dei componenti a lungo termine. Infatti, una copertura massima di 21 (prodotti finiti) + 14 (componenti) = 35 giorni non copre il tempo di consegna nominale di alcuni dei componenti. Vale la pena menzionare che in questa ottima condizione di flessibilità di assemblaggio, posizionare i buffer a livello di prodotti finiti rende il costo dell’inventario più elevato rispetto all’aumento dei buffer dei componenti per la stessa performance complessiva.
Ecco il grafico di simulazione di un prodotto finito: nota il livello medio intorno a 40.

Ed ecco il grafico di simulazione di un componente con leadtime lungo: osservare la disponibilità negativa costante, ovvero la carenza

Per ovviare a questa sfortunata situazione iniziale, possiamo pensare a un’importante riduzione del min max dei prodotti finiti, grazie alla già menzionata flessibilità della linea di assemblaggio e a un aumento significativo del min max dei componenti in base all’analisi della cronologia dei tempi di consegna, nello specifico ho impostato il min uguale al terzo quartile e il max uguale al terzo quartile più l’intervallo interquartile – non preoccupatevi se sembra magia nera, vi parlerò di quartili e intervallo interquartile più avanti. Ancora una volta, una simulazione a 10 iterazioni ci mostra il miglioramento: osserviamo limitate carenze di componenti mentre la riduzione delle scorte di prodotti finiti garantisce una buona disponibilità per i clienti.
Ecco il grafico di simulazione di un prodotto finito: notare il livello medio di inventario significativamente più basso.

Ecco il grafico di simulazione di un componente con lead time lungo: osservare le carenze prossime allo zero, ovvero la disponibilità negativa, una volta che l’inventario è in linea con la nuova politica min max.

I grafici sottostanti offrono una panoramica del miglioramento dal punto di vista finanziario: si può notare che le carenze di componenti con tempi di consegna lunghi sono notevolmente ridotte e il valore totale delle scorte è diminuito. Per maggiore precisione, il valore delle scorte dei prodotti finiti è teorico: in caso di carenze di componenti, l’assemblaggio non è possibile e ciò influisce sul livello di scorte previsto.

Curioso?
Suddividiamo il flusso di lavoro in fasi e analizziamo i dettagli del processo.
Fase uno: analisi dei dati storici e diagramma Box and Whiskers
Per prima cosa, analizziamo i set di dati storici: vogliamo studiarne la dispersione e l’asimmetria e rimuovere i valori estremi, poiché potrebbero portare a risultati di simulazione errati.
Il grafico Box and Whisker, noto anche come box plot, è uno strumento semplice e affidabile per studiare i set di dati; inoltre, Excel offre un pratico grafico per rappresentarlo.
Il grafico Box and Whisker è utile per:
- identificare la diffusione e l’asimmetria dei dati
- evidenziare le eccezioni
- confronto delle distribuzioni su più set di dati
Dobbiamo ordinare i nostri set di dati, domanda e tempi di consegna, in ordine crescente e calcolare i loro quartili.
In statistica, i quartili sono un tipo di percentile che divide il numero di punti dati in quattro parti, o quarti, di dimensioni più o meno uguali. I dati devono essere ordinati dal più piccolo al più grande per calcolare i quartili; pertanto, i quartili sono una forma di statistica d’ordine. I tre quartili, che danno origine a quattro divisioni di dati, sono i seguenti:
- Q1, il primo quartile, è definito come il 25° percentile, ovvero il punto in cui il 25% dei dati più bassi si trova al di sotto di questo punto. È anche noto come quartile inferiore.
- Q2, il secondo quartile, è la mediana di un set di dati; quindi il 50% dei dati si trova al di sotto di questo punto.
- Q3, il terzo quartile, è il 75° percentile, ovvero il punto in cui il 75% dei dati più bassi si trova al di sotto di questo punto. È noto come quartile superiore, poiché il 75% dei dati si trova al di sotto di questo punto.
Insieme al minimo e al massimo del set di dati, che sono anche quartili, rispettivamente Q0 e Q4, i tre quartili descritti sopra forniscono un riepilogo dei dati in cinque numeri.
Inoltre, l’intervallo interquartile (IQR – Inter Quartile Range) è una misura della dispersione statistica, definita come la differenza tra il terzo quartile (Q3) e il primo quartile (Q1).
L’IQR rappresenta l’intervallo entro cui si colloca il 50% centrale dei dati, fornendo informazioni sulla variabilità del set di dati escludendo al contempo i valori anomali.
Per quanto riguarda i valori anomali, useremo l’IQR per escluderli: scarteremo i valori inferiori a Q1 – 1,5 x IQR e superiori a Q3 + 1,5 x IQR.

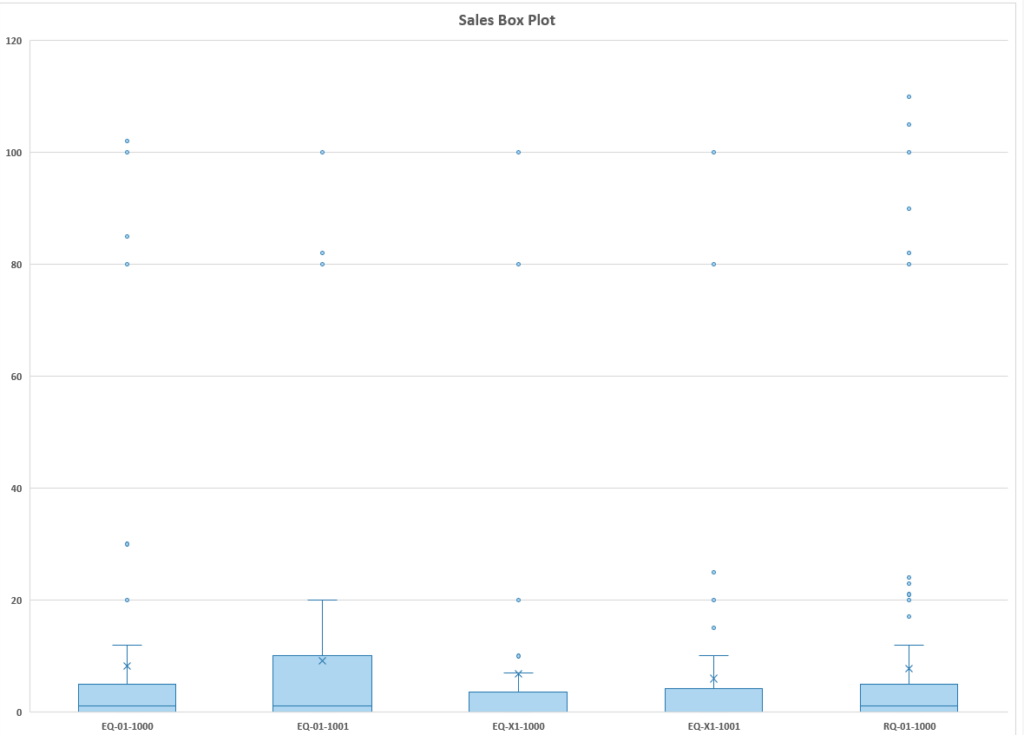
L’immagine qui sopra mostra il grafico Box and Whiskers di Excel. Ecco una breve spiegazione. Ecco come funziona.
Il riquadro (Box) rappresenta l’intervallo interquartile (IQR), ovvero l’intervallo tra il primo quartile (Q1) e il terzo quartile (Q3). Questo intervallo contiene il 50% centrale dei dati. La linea all’interno del riquadro rappresenta la mediana (Q2), che divide il set di dati in due metà uguali. Baffi (Whiskers):
I Baffi (Whiskers) si estendono dal riquadro ai punti dati più piccoli e più grandi nell’intervallo Q1 – 1,5 × IQR (limite inferiore) e Q3 + 1,5 × IQR (limite superiore). Questi baffi mostrano la dispersione dei dati, escludendo i valori anomali.
Valori anomali: i punti dati al di fuori dell’intervallo dei baffi (Whiskers) sono considerati valori anomali e sono in genere rappresentati come punti. Funzionalità aggiuntive:
I nostri grafici Box and Whiskers di Excel mostrano anche la media come un marcatore “X” per fornire ulteriori informazioni sulla tendenza centrale del set di dati.
Quanto è intelligente questa cosa? Possiamo ripulire i nostri dati dalle eccezioni, ottenere un riepilogo in poche cifre del nostro set di dati e una sua rappresentazione visiva.
Di seguito i box plot della cronologia delle vendite e della cronologia LT.

Fase 2: analisi della frequenza e istogramma della domanda e variazione del lead time.
Ora eseguiamo l’analisi di frequenza delle serie storiche dopo la rimozione dei valori anomali.
In altre parole, contiamo le ripetizioni di ciascun valore per ciascun codice parte.
Esprimiamo quindi la frequenza come percentuale del totale delle occorrenze.
La rappresentazione grafica di ciò è un istogramma, come mostrato nell’immagine.

Questa rappresentazione ci mostra la distribuzione dei nostri valori
Adesso utilizziamo gli istogrammi come una “distribuzione di probabilità”, ovvero estraiamo valori casuali all’interno di quelli mostrati negli istogrammi rispettando la percentuale di ogni valore così come era la probabilità di ogni valore.
Ecco il trucco: trasformiamo la percentuale in un numero proporzionale compreso tra 1 e 1000, ad esempio il 50% diventa 500 e l’1,3% diventa 13, quindi eseguiamo la funzione =randbetween(1,1000), che genererà un numero quasi casuale compreso tra 1 e 1000, quindi confrontiamo il risultato in una tabella cumulata che rispetta la percentuale di ripetizione dei nostri set di dati puliti per scegliere il valore corrispondente della domanda o del lead time per ciascun articolo.
Considerazione n. 1: la funzione =randbetween(1, 1000) genera numeri pseudo-casuali, ovvero apparentemente casuali, ma in realtà generati da un numero iniziale, o seed, e da un algoritmo. Tuttavia, riteniamo che la pseudo-casualità di Excel sia sufficientemente casuale per il nostro caso d’uso.
Considerazione n. 2: il metodo più utilizzato per generare i dati di simulazione della supply chain consiste nel selezionare una distribuzione, ad esempio la distribuzione normale, e parametrizzarla in base ai valori calcolati dal set di dati, ad esempio media e deviazione standard per la distribuzione normale. Tuttavia, selezionare la distribuzione corretta potrebbe essere molto difficile o portare a risultati privi di significato in caso di scelta errata. Il metodo che spiegherò potrebbe non includere valori mai presenti nelle serie storiche, ma è semplice e non richiede alcuna conoscenza statistica.
Fase tre: eseguire la simulazione
Abbiamo la nostra domanda di prodotti finiti, i tempi di consegna per la distribuzione dei componenti e un algoritmo per generarli: siamo pronti per la prima simulazione.
Generiamo la domanda giornaliera per ciascun prodotto finito per un anno, secondo la distribuzione spiegata in precedenza. Partendo dalle scorte disponibili, proiettiamo il livello di inventario applicando la logica min-max. Questo genera ordini di assemblaggio, per i quali avremo bisogno di componenti.
Esplodendo la distinta base (BOM) possiamo calcolare la domanda di componenti. Applichiamo nuovamente la politica min-max e generiamo la proiezione di inventario, tenendo conto questa volta del lead time generato casualmente dai componenti in base alla loro “distribuzione” e ai MOQ.
Al termine della simulazione, i risultati vengono trasmessi separatamente come file di testo per i prodotti finiti e per i componenti.
Per esportare i risultati della simulazione utilizziamo l’istruzione di automazione FEDT OUT, un’esportazione avanzata che consente di aggiungere un timestamp al nome del file, con una granularità massima di 1 secondo: ciò significa che se viene generato più di un file al secondo, sarà disponibile solo l’ultimo file esportato nello stesso secondo perché quelli generati in precedenza nello stesso secondo sono stati sovrascritti.
A meno che il tuo computer non sia molto potente o la tua simulazione estremamente semplice, la granularità di 1 secondo dovrebbe essere sufficiente; fammelo sapere nei commenti o mandami un’e-mail se hai bisogno di usare i microsecondi nel timestamp.
Considerazione: questa fase può essere complicata a piacere, ad esempio aggiungendo una schedulazione a capacità finita per i prodotti finiti o simulando un caso diverso con una distinta base multilivello e buffer DDMRP allocati lungo di essa. In questo caso, possiamo trarre vantaggio dai numerosi tutorial che noi di Production-scheduling.com abbiamo sviluppato nel corso di oltre 20 anni.
Fase quattro: iterare e report della simulazione
Quarto, ripetiamo il terzo passaggio più volte.
Per iterare utilizziamo l’istruzione di automazione FEDT NEXT, che fa sì che la macro di automazione scriva il codice necessario per scegliere il foglio di lavoro successivo da elaborare in fase di esecuzione, abilitando ramificazioni, cicli e ricorsione.
Una volta completate le iterazioni, riassumiamo in tabelle e grafici i risultati per i prodotti finiti e i componenti.
Se vogliamo confrontare diverse policy min-max, modifichiamo il file item.txt e ripetiamo il processo.
Lo strumento consolida tutti i file di testo disponibili per le simulazioni eseguite, consentendo di confrontare contemporaneamente diverse parametrizzazioni min-max.
Lo strumento: SimInv_v2.xlsb
Adesso vi guiderò attraverso il flusso di lavoro dello strumento.
Input
Abbiamo cinque file di testo di input
- items.txt: gli articoli con il loro codice, descrizione, quantità minima ordinabile, tempo di consegna nominale, copertura minima e massima in giorni di calendario, costo
- BOM.txt: la classica distinta base piatta: prodotto finito, componente e quantità per
- OnHand.txt: i livelli iniziali di inventario dei prodotti finiti e dei componenti
- SalesHistory.txt: la cronologia della domanda di beni finiti, è il set di dati utilizzato per calcolare la distribuzione da cui selezionare i valori di domanda casuali
- LTHistory.txt: la cronologia del lead time del componente, è il set di dati utilizzato per calcolare la distribuzione da cui selezionare i valori casuali del lead time

Calcoli
Ho già descritto il processo sopra: la simulazione esegue la proiezione a partire da due date e viene ripetuta più volte. Le tre cifre sono impostate nel foglio di lavoro PARA come segue:
- PARA_StartDate: 01/01/2025
- PARA_EndDate: 31/12/2025
- PARA_Iterations: 10
Ecco il diagramma del flusso del processo per darvi una panoramica visiva.

Di seguito alcuni dettagli tecnici.
Le distribuzioni della domanda e del lead time
Una volta eliminate le eccezioni, o se preferisci i valori anomali, e calcolata la percentuale di ciascun valore, possiamo usare =randbetween(1, 1000) e la ricerca approssimativa =match( …, …., 1) per ottenere il risultato corretto.
Moltiplichiamo prima per 1000 le percentuali e le cumuliamo partendo da 1: il risultato è una colonna che, se ricercata con =match(random(1, 1000), By1000 column, 1), estrae ogni valore in base a ogni percentuale – vedi la tabella sottostante: =match(… , …, 1) del nostro numero generato casualmente =randbetween(1, 1000), diciamo 503 così come qualsiasi altro valore compreso tra 472 e 723 inclusi, circa il 25,2% quindi, su By1000 selezionerà la riga che mostra 472, e quindi il valore Day Qty 1

Ho utilizzato lo stesso identico metodo sia per la domanda che per i tempi di consegna.
Power Query
Ho usato Power Query per unire o unire tabelle in linguaggio PQ e per impilarle o combinarle, oltre ad eseguire altri calcoli. Ho volutamente evitato di scrivere codice in linguaggio M per attenermi all’approccio “zero coding”.
Se non hai familiarità con Power Query, ti consiglio vivamente di leggere questo mio articolo per alcuni utili suggerimenti sull’integrazione tra Power Query e Fast Excel Development Template, in particolare sui parametri PARA passati a Power Query, sulla disabilitazione dell’aggiornamento in background e sull’integrazione all’interno del Pivot Template del Fast Excel Development Template e sull’opzione di caricamento dei dati nella tabella pivot di Power Query.
Ripetizione ed esportazione/importazione di file txt
Ho utilizzato l’istruzione di automazione NEXT per ripetere la simulazione della proiezione dell’inventario e l’istruzione OUT per esportare il risultato di ogni simulazione in un file txt diverso con un timestamp aggiunto al nome.
Sì, ma perché generare tutti quei file di testo?
Ottima domanda, in effetti. È possibile generare le simulazioni una dopo l’altra nella stessa tabella senza dover eseguire ripetizioni ed esportare i dati.
Tuttavia, il modo in cui ho scelto di procedere rende:
- la parte di simulazione più semplice e quindi più facile da sviluppare, eseguire il debug e mantenere in generale
- più facile adattare le formule e i fogli di calcolo a cui siamo abituati per la pianificazione e la programmazione (modularità)
- il sistema più resiliente a dataset di grandi dimensioni: ad esempio, la simulazione dei componenti di questo caso semplice richiede circa 9000 righe per esecuzione; l’impilamento dei file txt dell’esecuzione della simulazione viene eseguito in Power Query senza caricarli in un foglio di lavoro e i risultati vengono riepilogati nei report pivot, il numero massimo di righe di un foglio di lavoro Excel non è più un fattore limitante
Naturalmente l’esportazione e l’elaborazione dei file txt influiscono negativamente sulle prestazioni dello strumento e la gestione di set di dati di grandi dimensioni aumenta anche i tempi di elaborazione.
In generale, gli strumenti efficaci che si possono realizzare con il Fast Excel Development Template senza dover scrivere codice sono più lenti e richiedono più risorse rispetto alle applicazioni in Python. I vantaggi sono la semplicità di sviluppo, miglioramento e manutenzione, non le prestazioni.
Se stai cercando prestazioni elevate o devi gestire simulazioni molto grandi e sei pronto ad acquisire alcune competenze di programmazione Python, dai un’occhiata ai nostri contenuti sull’integrazione Python-Excel di cui ho già parlato sopra.
Report
Questo è uno degli strumenti più completi in termini di report che abbia mai condiviso con la community.
Elenchiamoli:
- SalesBoxPlot: il riepilogo numerico box and whiskers del set di dati storico vendite
- SalesBoxPlotChart: il grafico box and whiskers del set di dati storico vendite
- SalesStatistics: la tabella delle frequenze dei valori del set di dati storico vendite
- SalesStatsChart l’istogramma delle frequenze dei valori del set di dati storico vendite
- LTBoxPlot: il riepilogo numerico box and whiskers del set di dati storico lead time
- LTBoxPlotChart: il grafico box and whiskers del set di dati storico lead time
- LTStatistics: la tabella delle frequenze dei valori del set di dati storico lead time
- LTStatsChart: l’istogramma delle frequenze dei valori del set di dati storico lead time
- AssySimReport: Risultati della simulazione per prodotti finiti come tabella delle quantità
- AssySimChart: Risultati della simulazione per i componenti come grafico delle quantità
- AssySimCostReport: Risultati della simulazione per prodotti finiti come tabella dei costi
- AssySimCostChart: Risultati della simulazione per prodotti finiti come grafico dei costi
- CompoSimReport: Risultati della simulazione per i componenti come tabella delle quantità
- CompoSimChart: Risultati della simulazione per i componenti come grafico delle quantità
- CompoSimCostReport: Risultati della simulazione per i componenti come tabella dei costi
- CompoSimCostChart: Risultati della simulazione per i componenti come grafico dei costi
Considerazioni sulle prestazioni
Questo strumento non è sicuramente iperveloce.
Infatti le performance sono influenzate da:
- il caricamento dei dati di input
- il numero di esecuzioni di simulazione
- il numero di pseudo-casuali estratti
- la complessità del modello che stai simulando, ripetuta per ogni simulazione
- l’esportazione in file txt di ogni risultato di simulazione per il prodotto finito e per i componenti, due file ripetuti per ogni simulazione
- una volta per ogni esecuzione dello strumento, l’importazione e l’impilamento dei file txt generati durante l’esecuzione corrente e rimasti dalle simulazioni precedenti
Ho effettuato alcuni test su un Lenovo ThinkPad E550 di 10 anni dotato di CPU Intel(R) Core(TM) i7-5500U CPU @ 2.40GHz, 2394 Mhz, 2 core, 4 thread, 16 GB di RAM DDR3, SSD Sata, Windows 11 24H2 e Microsoft 365.
Le 985500 righe della simulazione delle 100 esecuzioni del componente vengono gestite senza problemi
Su questa macchina, 10 corse durano circa 7 minuti, 50 corse durano 33 minuti e 100 corse durano 1 ora e 6 minuti.
Su un laptop con CPU Intel i5 di 11a generazione, 16 GB di RAM DDR4, SSD m2 il tempo di elaborazione si riduce notevolmente: 10 esecuzioni impiegano circa 3 minuti, 50 impiegano 16 minuti; 100 esecuzioni impiegano 32 minuti.
Tieni presente che un simulatore è in genere uno strumento di progettazione e collaudo, non uno strumento di uso quotidiano, quindi la velocità di elaborazione non è così importante.
Inoltre, il numero di iterazioni necessarie per una simulazione informativa è variabile e il punto ottimale di equilibrio tra contenuto informativo e tempo di esecuzione è spesso inferiore a quanto ci si aspetterebbe.
Ad esempio, di seguito sono riportati i grafici delle 5, 10, 20 e 100 iterazioni del nostro modello per un componente con lead time lungo: il grafico delle 10 iterazioni è sufficientemente informativo, mentre l’aggiunta di iterazioni aggiunge solo un valore marginale.


Per ottenere numerose iterazioni che non tengano occupato Excel per lungo tempo, è possibile eseguire piccoli batch ripetuti, ad esempio 10 volte 10 iterazioni per un totale di 100 iterazioni: ci vuole più tempo di 100 iterazioni in una sola volta, ma i set di dati risultanti sono equivalenti.
Se hai davvero bisogno di un numero elevato di iterazioni, puoi federare più laptop e consolidare i risultati in un unico report modificando il prefisso del file esportato per ciascun PC nel foglio di lavoro PARA, parametro PARA_Prefix. Tieni presente che dovrai rigenerare la macro di automazione facendo clic due volte sul pulsante “Cambia automazione” nel foglio di lavoro “Menu” o ripetendo due volte la combinazione di tasti Ctrl + Maiusc + A su ciascun PC. Inoltre, saranno necessarie alcune modifiche ai report di simulazione per evitare sovrapposizioni di simulazioni con timestamp identico al secondo provenienti da macchine diverse. Non ho testato la simulazione federata.
Download dello strumento e conclusione
Per scaricare lo strumento compila il modulo sottostante, riceverai un link per il download.
Inventory Simulation in Excel Download
Una volta scaricato, decomprimi il file zip compresso in C:.
Avrete una cartella denominata C:\P-S_SimInv con il Fast Excel Development Template che ho utilizzato per creare lo strumento, il file Excel SimInv_v2.xlsb, che è lo strumento, e una sottocartella Data, contenente i file di input txt; in particolare, items.txt è l’input effettivamente caricato mentre items_bad.txt e items_good.txt sono backup rispettivamente con la politica min max errata e con la politica min max corretta.
I dati di simulazione vengono memorizzati separatamente nella cartella Archive/Assy per i prodotti finiti e nella cartella Archive/Compo per i componenti: tenete presente che questi non vengono mai eliminati automaticamente e che vengono tutti raggruppati per i report di simulazione. Da un lato, potete confrontare diverse simulazioni, dall’altro, se non pulite queste cartelle, i report si riempiranno di dati inutili.
È possibile modificare la cartella di lavoro modificando il contenuto di Menu!B10, ma assicurarti di ricostruire la macro di automazione facendo clic due volte sul pulsante Switch Automation nel foglio di lavoro Menu o ripetendo due volte la scorciatoia Ctrl + Maiusc + a.
Abbiamo imparato come realizzare uno strumento di simulazione completo senza scrivere codice.
Ora puoi creare il tuo simulatore specifico o adattare questo al tuo caso d’uso senza scrivere codice.
E naturalmente, per qualsiasi dubbio o preoccupazione, contattami via email (gabriele at production-dcheduling.com).